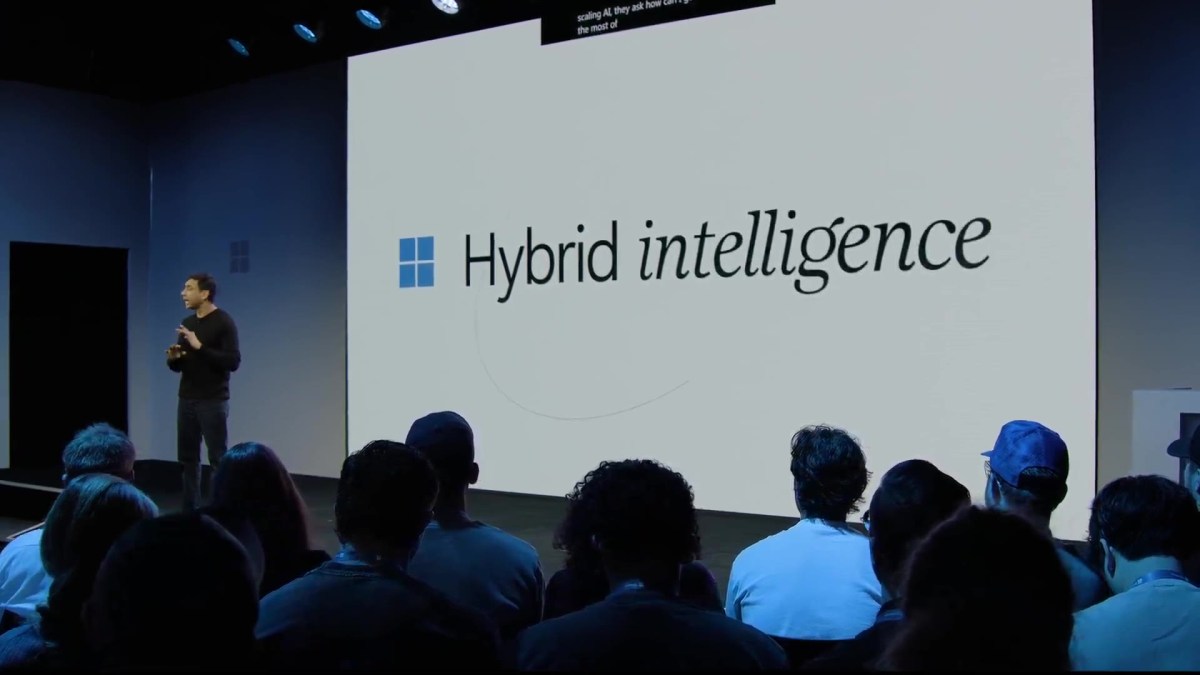
Microsoft veut faire tourner de gros modèles d’IA directement sur les PC Windows, et l’a montré ce mercredi 7 octobre, lors de son événement Windows et Surface, largement consacré aux agents IA.
Microsoft appelle ça « l’intelligence hybride ». Le modèle local traite ce qu’il peut, et le système bascule vers le cloud (GPT, Claude, Gemini, etc.) quand la tâche l’exige. Selon l’entreprise, ses clients veulent surtout tirer le meilleur parti de leurs budgets de jetons sans renoncer aux modèles les plus performants.
MAI Code 1.1 Flash, disponible dans GitHub Copilot depuis le 11 août, compte 130 milliards de paramètres (C’est un mélange d’experts dont 6,8 milliards sont actifs à chaque jeton). Ces paramètres sont les réglages internes appris par le modèle, et leur nombre donne une idée de sa taille. Microsoft l’a quantifié en 3 bits, c’est-à-dire qu’il stocke chacun de ces réglages avec beaucoup moins de précision qu’à l’origine.
Sa taille baisse ainsi de près de 80 % « tout en préservant la qualité du code », selon la marque. Microsoft annonce en local une fenêtre de contexte de 256 000 jetons, soit la quantité de texte ou de code qu’il peut garder en tête d’un seul coup.
Côté Nvidia, le nouveau Nemotron, attendu le 15 octobre, dépasse les 70 milliards de paramètres. Quantifié en 2 bits, il occupe un peu plus de 20 Go de mémoire. Microsoft le destine aux machines équipées de la puce RTX Spark de Nvidia, comme le mini Surface pensé pour l’IA en local.
DeepSeek V4 Flash est le plus gros des trois, avec 284 milliards de paramètres. Quantifié en 1,6 bit, il tient dans 60 Go de mémoire. D’après Microsoft, il dépasse GPT-5, sorti en août 2025 et remplacé depuis par la gamme GPT-6, sur les tests de codage et de raisonnement, un niveau qui était encore réservé il y a un an aux modèles les plus avancés, hébergés dans le cloud.
Le modèle reste utilisable à cette taille parce qu’il s’agit d’un mélange d’experts (MoE) : sur ses 284 milliards de paramètres, seuls 13 milliards travaillent à chaque jeton généré, ce qui allège le calcul mais pas la mémoire. Ses poids sont publics et on peut déjà le faire tourner en local, mais sa version quantifiée en 3 bits pèse 103 Go et réclame une machine dotée de 110 Go de mémoire, selon Unsloth, qui distribue ces fichiers. La compression de Microsoft retire donc encore environ 40 % à ce poids.
Pour autant, la comparaison avec GPT-5 vient de tests maison, qu’il faudra confronter à des évaluations indépendantes. Une compression aussi poussée se paie en général sur la qualité des réponses. Enfin, 60 Go de mémoire libre restent rares sur un PC, alors que Microsoft juge désormais 8 Go de RAM suffisants pour le grand public.
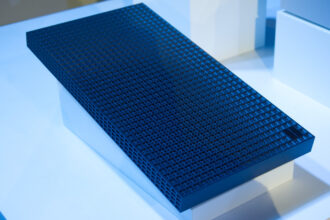
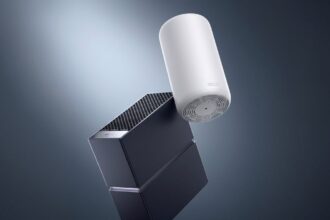
Les machines visées sont donc surtout les PC équipés de la puce RTX Spark de Nvidia, qui peut embarquer jusqu’à 128 Go de mémoire unifiée, partagée entre processeur et carte graphique. Le Surface RTX Spark Dev Box, le mini PC de Microsoft pensé pour l’IA en local, en est doté, avec jusqu’à un pétaflop de calcul IA annoncé par la marque.
Côté outils, Microsoft mise sur sa filiale GitHub. HydraFusion, lancé en préversion début septembre pour envoyer chaque tâche vers le bon modèle dans le cloud, arrive sur Windows le 15 octobre et pourra appeler des modèles installés en local.
Lors de la démonstration, GitHub Copilot sur Windows a reçu le code source de Windows Terminal, copié sur la machine, avec une consigne : repérer le code inutilisé, les imports, les paquets et les fonctions obsolètes, puis en tirer un résumé exploitable.
L’option d’efficacité automatique choisit le modèle selon la complexité de la tâche, et bascule désormais vers un modèle local pour les plus simples. Ici, MAI Code 1.1 Flash a fait le travail sur la machine, avec la charge du GPU affichée à l’écran comme preuve. Kayla Cinnamon, qui menait la démonstration, a même assuré qu’on aurait pu passer en mode avion sans couper le traitement.
Le second scénario mélangeait les deux. Un agent sous GPT-6 Luna, dans le cloud, a passé en revue les tickets du dépôt Windows Terminal marqués « needs repro », c’est-à-dire les bugs à reproduire. Il a ensuite confié les recherches, compilations et tests à trois sous-agents locaux sous MAI Code 1.1 Flash. L’un d’eux affichait 1,6 million de jetons envoyés et 10 500 renvoyés, présentés comme gratuits puisque traités sur le PC.
Pour donner un ordre de grandeur, ce même volume facturé au tarif de GPT-6 Luna, le modèle le moins cher de la gamme GPT-6 d’OpenAI (0,10 dollar par million de jetons envoyés, 0,50 dollar par million de jetons renvoyés), reviendrait à environ 0,17 dollar, soit une quinzaine de centimes d’euro. L’économie se mesure donc surtout sur des agents qui enchaînent ce type de tâches toute la journée.
Pour faire tourner le tout, Microsoft s’appuie sur Windows ML, son moteur d’exécution qui répartit les modèles entre processeur, carte graphique et NPU (la puce dédiée à l’IA).
L’entreprise annonce aussi l’intégration à Windows ML de llama.cpp, l’outil open source qui doit donner aux développeurs l’accès aux nouveaux modèles libres dès leur sortie. En revanche, Microsoft n’a détaillé ni la configuration minimale de ces modèles, ni les critères exacts qui font basculer une tâche vers le cloud.
Votre café et votre dose de tech vous attendent sur WhatsApp chaque matin avec Frandroid.
Pour nous soutenir gratuitement, dites simplement à Google d’ajouter Frandroid à vos sources préférées en cliquant ici.
Journaliste tech depuis 2013 et Chef de rubrique Survoltés chez Frandroid depuis 2022.
Mon quotidien ? Décortiquer la mobilité de demain et la transition énergétique. Je suis spécialiste des voitures électriques, des écosystèmes d'énergie (panneaux photovoltaïques, batteries) et du hardware (PC et Mac).
Fasciné par le sifflement des moteurs électriques et leur couple instantané, je suis aussi un cycliste du dimanche (gravel) et un explorateur des capacités offertes par l'intelligence artificielle dans la vie quotidienne.
C'est enregistré ! Surveillez votre boîte aux lettres, vous allez entendre parler de nous !