Si vous avez besoin d'une grande puissance pour exécuter des tâches d'IA, mais que vous disposez de peu d'espace, VZmore propose un PC qui vous conviendra parfaitement.
Les points clés à retenir sur le VZmore AX9 Max Mini PC
J’ai testé l’IA sur presque tous les ordinateurs que je possède, avec plus ou moins de succès. Bien sûr, la complexité de la tâche détermine généralement ses performances sur un ordinateur de bureau ou un portable donné. Je peux ouvrir une IA installée localement et poser une question simple, à laquelle je recevrai une réponse presque immédiatement.
Ou bien, je pouvais demander à l’IA installée localement d’écrire une application pour moi et la voir se bloquer complètement jusqu’à ce que le traitement soit terminé.
C’est généralement le cas avec l’IA installée localement. C’est particulièrement vrai lorsque la machine en question ne dispose pas d’un GPU NVIDIA. Ainsi, lorsque l’entreprise m’a demandé de tester son tout nouveau mini-PC équipé d’un processeur AMD et spécialement conçu pour l’IA, ma première pensée a été que j’obtiendrais des résultats similaires à ceux que j’avais observés avec d’autres machines non équipées de NVIDIA. J’avais tort. Complètement tort.
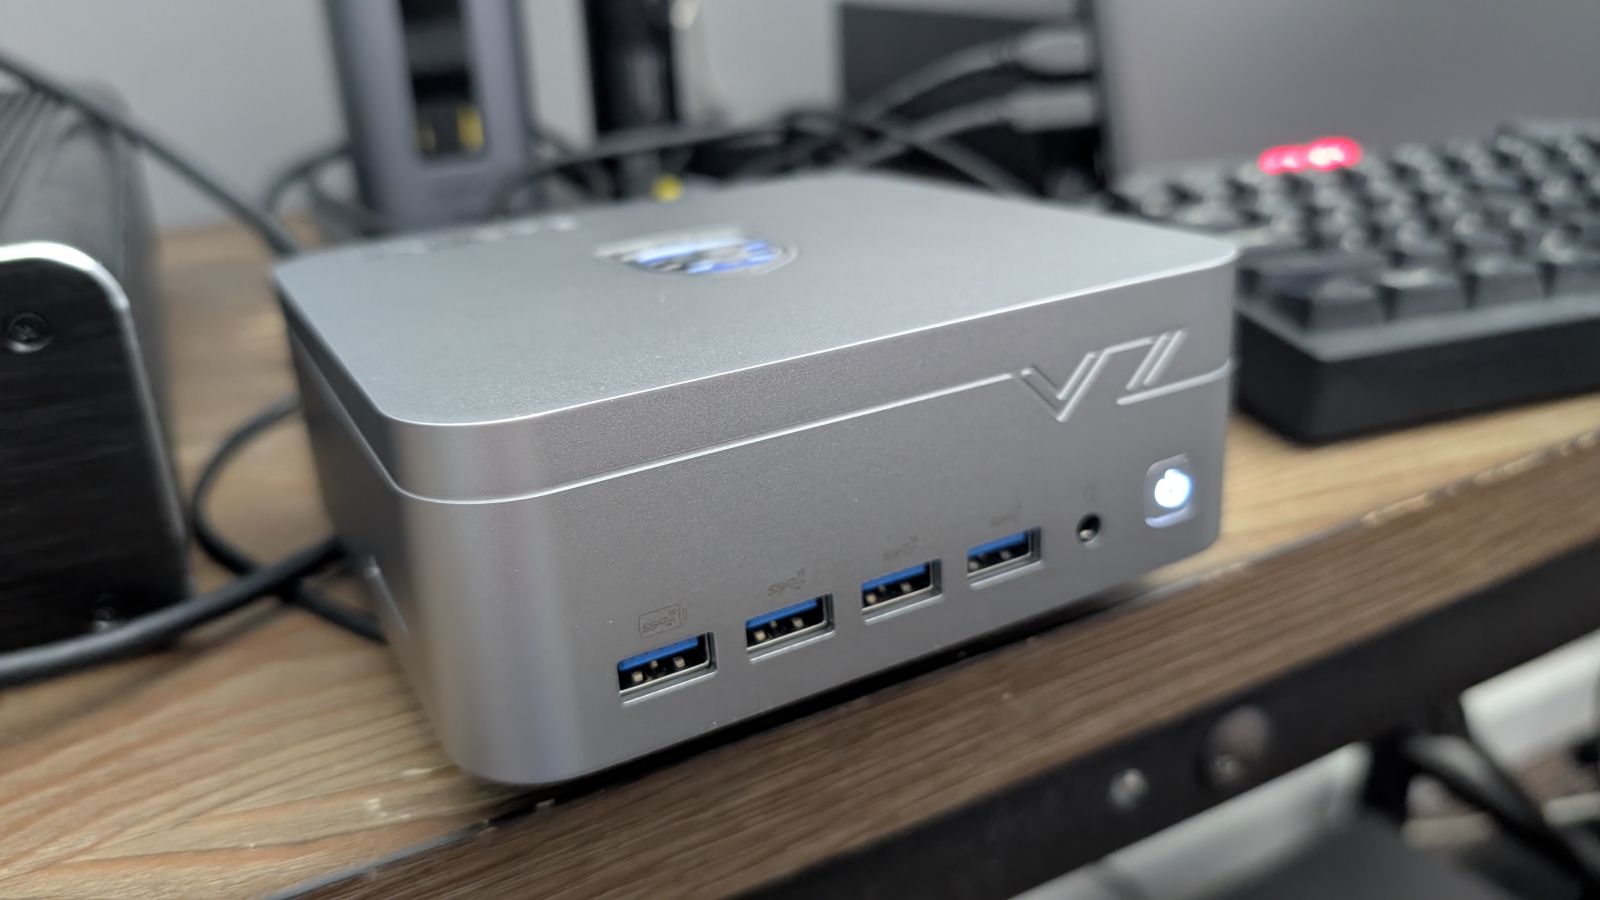
Le mini-PC VZmore AX Max est un PC au format compact équipé d’un processeur AMD Ryzen AI 9 HX 470, d’un GPU Radeon 890M, de 32 Go de mémoire vive SO-DIMM et d’un SSD M.2 de 1 To. Ce PC mesure 5,3 x 5,2 x 2,3 pouces, il ne prend donc pas beaucoup de place.
La description de l’appareil indique que l’AX Max Mini dispose d’un NPU capable de traiter jusqu’à 86 TOPS de performances IA globales et qu’il est conçu pour les workflows IA locaux.
Il prend en charge LM Studio, Ollama et AMD GAIA pour exécuter localement les modèles compatibles Qwen, Llama, Gemma et DeepSeek, ce qui réduit la dépendance vis-à-vis des services d’IA basés sur le cloud et permet de conserver les données sensibles sur l’appareil.
La première chose que j’ai faite a été d’installer Fedora Linux par-dessus le système d’exploitation Windows préinstallé. Je suis bien plus à l’aise avec Linux qu’avec Windows et j’ai estimé que cet OS open source me permettrait de juger au mieux le matériel en toute impartialité.
Au bout des 2 minutes nécessaires à l’installation de Fedora, j’étais prêt à configurer la machine pour le test proprement dit. Pour cela, j’ai installé l’interface graphique Ollama, Moose, à l’aide de la commande : flatpak install flathub io.github.moooossee.Moose
Une fois l’installation terminée, j’ai laissé Moose télécharger et installer Ollama, puis récupérer le modèle qwen3-coder:30b (car je savais que j’allais utiliser Ollama pour générer une application web à des fins de test).
La machine étant désormais prête pour les tests, il était temps de se lancer.
J’ai demandé à Ollama, Moose et qwen3-coder de générer une application web capable de recueillir les mesures fournies par l’utilisateur pour des costumes de théâtre, de les enregistrer dans une base de données, et de permettre à l’utilisateur de se connecter et d’enregistrer ses informations.
Je m’attendais tout à fait à ce que la machine s’acharne sur cette tâche pendant un certain temps avant de cracher lentement le code. À ma grande surprise, elle a immédiatement commencé à répondre et a fini par générer une application web d’environ 1 500 lignes de code.
Malgré tout, j’ai installé Apache sur la machine (une autre raison pour laquelle j’ai préféré Linux à Windows), j’ai copié le code dans un fichier que j’ai nommé costume.html, j’ai déplacé ce fichier dans le répertoire racine d’Apache (/var/www/html), j’ai lancé mon navigateur et je l’ai redirigé vers http://localhost/custom.html.
Non seulement elle a fonctionné, mais elle a même très bien fonctionné. J’ai dû corriger plusieurs problèmes dans le code (notamment des problèmes liés aux commandes de base de données), mais une fois ces corrections apportées, l’application a fonctionné à la perfection.
La plus grande surprise pour moi a été que, pendant qu’Ollama s’affairait à créer les différents fichiers de l’application (config.php, login.php, logout.php, measurements.php, signup.php), j’ai pu utiliser la machine comme si de rien n’était. Le VZmore AX Max s’est acquitté de la tâche sans même ciller.
La conclusion est simple : le VZmore AX Max Mini est un PC compact idéal pour exécuter des tâches d’IA en local, non seulement pour une conversation générale, mais aussi pour des processus bien plus complexes, tels que la création d’applications viables, sans pour autant paralyser le système.
A tel point que je me vois bien l’utiliser comme machine dédiée à l’IA dans mon laboratoire personnel.
En effet, j’ai configuré Ollama de manière à pouvoir m’y connecter depuis n’importe quel ordinateur de mon réseau local, ce qui m’évite d’exécuter l’IA en local sur mon ordinateur de bureau principal ou mon ordinateur portable, et cela fonctionne parfaitement.
Je tiens toutefois à préciser ceci : l’exécution d’Ollama via un réseau local est loin d’être aussi rapide que lorsqu’on l’exécute directement sur la machine.
Si vous souhaitez utiliser l’IA en local mais que vous ne disposez pas de la place nécessaire pour un PC de bureau encombrant, le mini-PC VZmore AX Max est une véritable bête de course qui répondra très bien à vos besoins en matière d’IA locale.
À 1 1550 €, vous auriez du mal à trouver une meilleure offre pour un PC prêt pour l’IA.
Vous bénéficiez également de nombreux ports pour ajouter des périphériques et même connecter jusqu’à quatre écrans.
Sans renoncer à ses datacenters, l’entreprise de transport G7 va chercher de la puissance de calcul et du traitement big data sur le cloud public de S3NS. Le cloud SecNumCloud doit en particulier héberger ses nouveaux outils d’IA.
La réglementation de l'IA au travail progresse lentement outre-Atlantique. Mais elle en est encore au stade des initiatives au niveau des États.
Les fournisseurs présentent l'IA comme la panacée pour les systèmes informatiques legacy. Mais est-ce vraiment le cas ?
Samsung aurait abaissé son objectif de livraisons de smartphones en 2026 et réduit ses commandes de composants au quatrième trimestre. La flambée des prix de la mémoire pèserait sur la demande et sur sa place de numéro un face à Apple.