Un report pour faire tomber la température

Meta repousse au 20 novembre ses nouvelles conditions commerciales, contestées par les éditeurs de presse et les annonceurs. Trois semaines de répit pour expliquer ses intentions : gros travail en perspective au vu de la méfiance des premiers concernés.
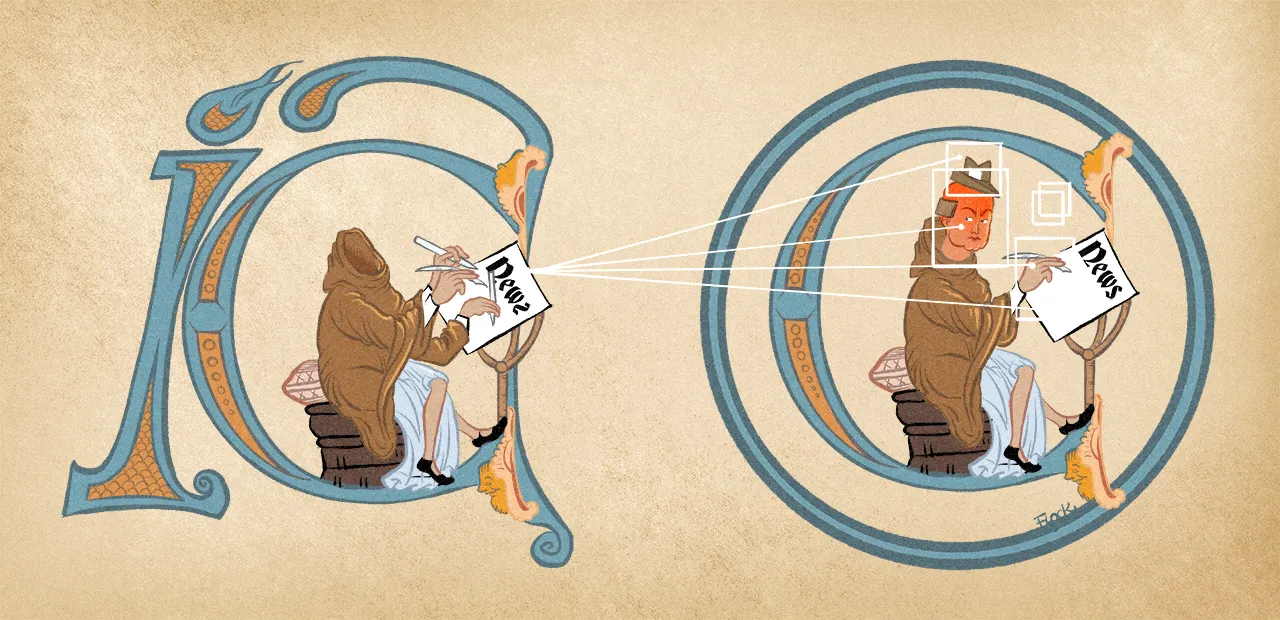
Meta reporte la mise en œuvre de ses conditions commerciales pour les utilisateurs pros : la date fatidique passe du 30 octobre au 20 novembre, ce qui devrait lui donner du temps pour mieux expliquer de quoi il retourne. La confusion règne en effet, depuis la découverte la semaine dernière que le géant des réseaux sociaux voulait se donner le droit de moissonner le contenu des sites web pour entraîner ses modèles d’IA, sans compensation ni demande de consentement.
Doutes tenaces
Dans le détail, les conditions commerciales de Meta l’autorisaient à utiliser des crawlers pour « accéder, indexer, mettre en cache, analyser, collecter, récupérer ou explorer les domaines, les pages Web ou les URL (…) associés [aux] produits ou services » gérés par des utilisateurs professionnels (les organisations et entreprises qui exploitent une page Facebook ou un compte Instagram, comme un éditeur de presse ou un annonceur).
Les conditions précisaient surtout que les contenus collectés de la sorte pouvaient « fournir, développer, améliorer, rechercher, entraîner et maintenir l’intégrité des produits, des services et des fonctionnalités des entités Meta ». Des experts ont tiqué sur le mot « entraîner » qui après la bronca, a disparu dans une nouvelle version du texte.
Entre-temps, les autorités antitrust britanniques et européennes ont reçu des plaintes déposées par des éditeurs de presse et des annonceurs, craignant que Meta s’accorde la possibilité d’utiliser leurs contenus pour son IA. « Nous reportons au 20 novembre l’entrée en vigueur de nos conditions commerciales et de nos conditions relatives aux publicités en libre-service mises à jour, afin de disposer de plus de temps pour expliquer à nos partenaires et aux parties prenantes ce qui change et ce qui ne change pas », a indiqué un porte-parole à Reuters.
Robots.txt n’est pas un contrat
L’entreprise veut expliquer aux méfiants de quelle manière elle se sert de ses crawlers, et surtout les rassurer sur un point : elle affirme respecter les consignes contenues dans le fichier robots.txt. La Commission européenne salue le report auprès de l’agence de presse ; en revanche, le Conseil européen des éditeurs (EPC) pousse toujours les régulateurs à exiger une suspension des conditions d’utilisation le temps d’examiner la question.
Angela Mills Wade, directrice exécutive du Conseil, a ainsi déclaré que « gérer une page professionnelle ou faire la publicité d’un abonnement ne devrait pas donner de droits généraux sur le site web et les archives d’un éditeur ». « Toute utilisation allant au-delà de ce qui est nécessaire pour fournir le service expressément demandé devrait nécessiter une autorisation distincte et explicite du titulaire des droits concerné », a-t-elle ajouté.
Pour l’EPC, le fichier robots.txt ne peut remplacer « des limites claires et juridiquement contraignantes » à la collecte et à la réutilisation des données. En France, le GESTE (groupement des éditeurs de services en ligne) s’est rangé du côté du WAN-IFRA, l’association mondiale des éditeurs de presse, qui demande la suspension de la mise en route des conditions d’utilisation.