Sur un stand, tout marche, et l’Editor’s Day organisé par Nvidia à San Francisco début octobre n’a pas échappé à la règle. Nvidia résume son ambition en trois mots, « The One PC », une seule machine pour créer, jouer et faire tourner des agents IA. Microsoft, lui, promet que Windows est prêt à l’accueillir.
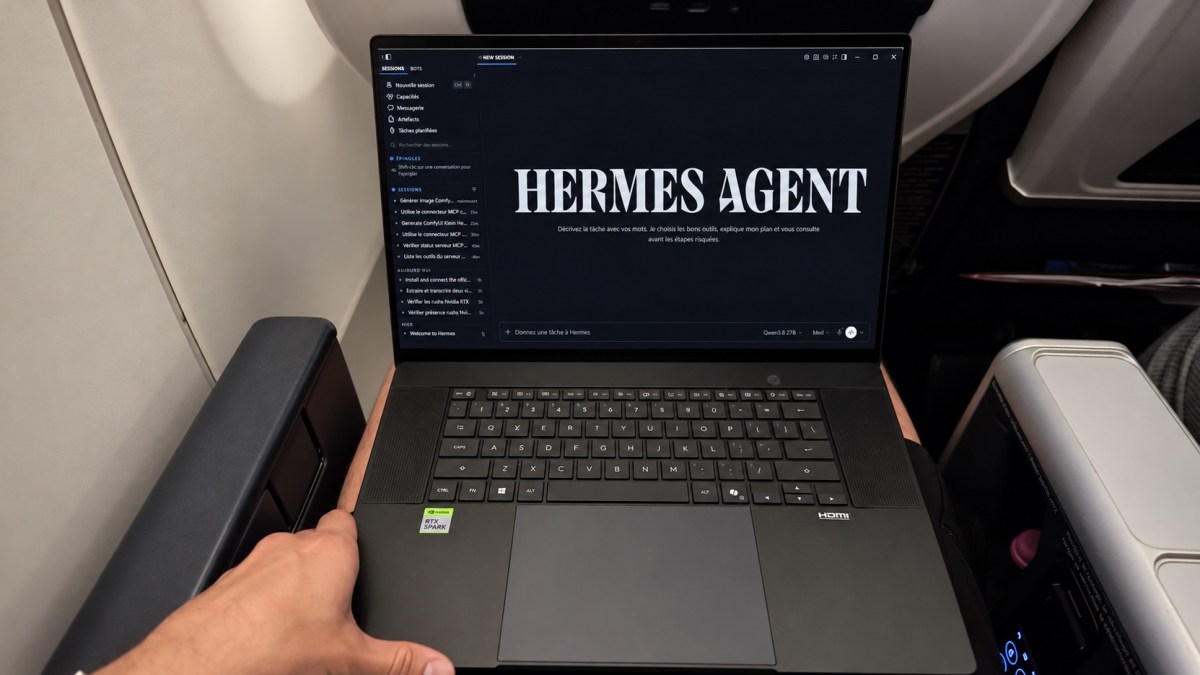
J’ai voulu voir ce qu’il en reste quand c’est moi qui installe tout, loin de toute prise. Le vol retour m’en donnait l’occasion : onze heures en mode avion, sans le Wi-Fi de bord, avec des modèles téléchargés avant le départ. Mes questions, mes notes, mes vidéos, mon travail de la semaine : tout devait passer par la machine.
Cet article est un retour d’expérience en conditions réelles. Le test complet, en jeu, en création, en autonomie et face au MacBook Pro, c’est mon collègue Ulrich Rozier qui l’a mené, et j’en reprends quelques chiffres plus bas.
Pour aller plus loin On a testé la puce Nvidia RTX Spark qui veut réinventer le PC : les résultats face à Apple, AMD et une RTX 5070
La RTX Spark réunit dans un même boîtier un processeur Arm de 18 ou 20 cœurs selon la version, conçu avec MediaTek, et un GPU Blackwell, de la même génération que les GeForce RTX 50. Surtout, les deux puisent dans la même mémoire unifiée, jusqu’à 128 Go à 300 Go/s.
C’est ce point qui compte pour l’IA : pour répondre vite, un modèle doit tenir entièrement dans la mémoire de la puce qui calcule, en général la carte graphique. Une RTX 5070 portable se contente de 8 Go de mémoire vidéo (12 Go pour la RTX 5070 Ti), de quoi faire tourner un petit assistant. Ici, le GPU peut s’en réserver plusieurs dizaines de Go.
Ma machine est un Asus ProArt P16 en 64 Go de RAM, la version intermédiaire, vendue 5 299,99 € en France. Certaines promesses de Nvidia exigent la version 128 Go : on verra ce que la moitié de la mémoire fait perdre.
Le ProArt P16 sort en France ce vendredi 16 octobre, à la Fnac, chez Darty, Boulanger, Amazon et sur la boutique en ligne d’Asus. La gamme va de 24 à 128 Go de mémoire unifiée : la version d’entrée (24 Go, 512 Go de stockage) est affichée à 3 299,99 €. Le PC RTX Spark le moins cher en France est le Surface Laptop Ultra de Microsoft, à 2 899 €, avec une puce 18 cœurs et 24 Go.
Lenovo, HP et Dell ont eux aussi ouvert les précommandes de leurs PC portables RTX Spark, avec des premières livraisons ce vendredi 16 octobre aux États-Unis.
J’ai emporté cinq modèles, tous ouverts : deux modèles chinois d’Alibaba, Qwen 3.6 35B, rapide, et Qwen 3.8 27B, plus récent et plus réfléchi ; Qwen3 Coder 30B, spécialisé dans le code ; gpt-oss-20b, d’OpenAI ; et Nemotron 3.5, de Nvidia. S’y ajoute Whisper, l’outil de transcription d’OpenAI.
Première surprise : sur mes 64 Go, l’IA n’a pas droit à tout. La part réservée au GPU se règle dans l’application Nvidia, et elle est de 48 Go par défaut sur ma machine. Windows ne garde alors que 16 Go pour tout le reste, ce qui devient vite étroit.
J’ai d’ailleurs tenté de charger gpt-oss-120b, le gros modèle ouvert d’OpenAI : refus en trois secondes. Il réclamait 59,9 Go de mémoire graphique, la machine en exposait 55,9.
À San Francisco, presque toutes les démos tournaient autour d’un mot : agent. Une IA qui agit elle-même sur l’ordinateur : elle ouvre des fichiers, lance des logiciels, enchaîne les étapes. J’en utilise déjà deux chez moi, Hermes et OpenClaw, sur un mini-PC allumé jour et nuit, ce que Microsoft appelle une « claw box ». Mais leur cerveau est dans le cloud, avec Claude et GPT.
Nvidia promet de le rapatrier dans l’ordinateur. Sur scène, le patron de Nous Research, qui développe Hermes, l’a fait tourner déconnecté du réseau, à 57 tokens par seconde, sur une machine de 64 Go, exactement la mémoire de la mienne.
Reste la question qui fâche : un agent qui agit sur votre ordinateur peut aussi effacer vos fichiers. Nvidia a résumé le dilemme en deux mots. « YOLO » : on donne tout à l’agent et on croise les doigts. « Alcatraz » : on bloque tout, il demande la permission à chaque geste, et au dixième « autoriser », on clique sans lire.
Microsoft promet l’entre-deux avec ses Execution Containers, disponibles sur Windows 11 : l’agent devient un utilisateur à part entière, avec son propre compte, comme un enfant à qui l’on prête l’ordinateur. On choisit les dossiers qu’il peut lire ou modifier et s’il a droit à Internet, et Windows fait lui-même respecter la règle, quoi que décide l’agent. Nvidia y ajoute OpenShell, sa couche de surveillance.
Côté simplicité, la promesse est tout aussi nette : Windows proposera de choisir un agent, Hermes, OpenClaw ou Perplexity, installé « en deux clics » depuis le Microsoft Store. Pas au premier démarrage, précise Microsoft, mais après une période d’utilisation dont la durée n’est pas donnée.
Je n’ai pu vérifier ni la sécurité ni les deux clics. Le menu qui propose l’agent n’existait pas dans la version de Windows installée sur ma machine de test, et les niveaux de protection d’OpenClaw non plus. La version complète de Hermes, avec la sécurité de Windows et de Nvidia, n’est d’ailleurs attendue que « d’ici fin octobre », après la sortie des machines ce vendredi 16 octobre.
Sur le PC reçu, aucun modèle d’IA. Un acheteur partira de zéro, et moi aussi : j’ai tout installé à la main, tant que j’avais le Wi-Fi. Nvidia prévient lui-même que tous les outils de développement ne sont pas encore prêts pour Arm. Sur scène, son responsable l’a reconnu : « ça me fait mal, on n’est pas arrivés à 100 % ».
Je commence par ce que la plupart des gens font avec ChatGPT : une question pratique. « Je suis dans un avion entre San Francisco et Paris, j’atterris samedi à 15 h 50 avec 9 heures de décalage horaire. Donne-moi un plan concret heure par heure pour être en forme lundi matin : quand dormir, quand manger, la lumière, la caféine. Sois concret et court ».
Qwen 3.6 répond à environ 70 tokens par seconde (un token correspond à un mot ou à un morceau de mot), bien plus vite qu’on ne lit. Le plan est propre, découpé jour par jour : lumière naturelle maximale à l’arrivée, dîner léger, coucher vers 21 h 30, caféine le matin seulement, sieste de 20 minutes au plus. Rien de génial, rien de faux non plus.
Je relance : « Et si je dois tourner une vidéo dimanche après-midi, je décale quoi ? ». La réponse arrive aussi vite, puisque le modèle a gardé la conversation en mémoire. Le seul moment d’attente, c’est le chargement du modèle au lancement, quelques dizaines de secondes.
C’est le cas d’usage qui justifie le plus l’IA locale : des données qui ne doivent pas sortir de la machine. Mes notes de l’Editor’s Day, en grande partie des transcriptions des présentations, étaient sous embargo. Je n’avais pas le droit de les laisser fuiter. Je les colle dans Qwen 3.8 27B avec une consigne précise : les résumer en dix points, lister ce que Nvidia affirme sans preuve chiffrée, et proposer huit questions que mon collègue Ulrich devra vérifier pendant son test.
Jusqu’à 330€ d’avantages avec nos offres Hello Prime ou Hello Prime Duo, dont 80€ cash à l’ouverture de compte !
Le modèle avale plus de 11 000 tokens de notes en 17 secondes, puis rédige pendant un peu plus de deux minutes, pour 3 % de batterie consommée. Il écrit nettement moins vite que le précédent, autour de 16 tokens par seconde, car ce modèle « dense » relit ses 27 milliards de paramètres pour chaque mot, quand Qwen 3.6 n’en active qu’environ 3 milliards.
Avec le décodage spéculatif, qui lui fait deviner plusieurs mots à la fois, il monte entre 24 et 31 tokens par seconde. Le résultat m’a bluffé : complet, hiérarchisé, avec de vraies questions de vérification, sans aucun accès à Internet.
L’IA locale se paie aussi en chaleur et en bruit. Quand on interroge ChatGPT, l’ordinateur reste froid, puisque les calculs se font dans un datacenter. Ici, c’est le PC qui calcule. En mode Performance, l’air soufflé sur mes genoux était à la limite du supportable, et les ventilateurs se faisaient entendre comme en plein jeu vidéo.
Whisper (version large-v3-turbo) a ensuite transcrit mes rushs de San Francisco, pour garder à l’écrit ce que j’avais entendu sur place. Sur le GPU, il traite un extrait vidéo de 80 secondes en 5,35 secondes, quinze fois plus vite que le temps réel, avec un texte identique au mot près à celui obtenu au sol. En mode automatique, il gère aussi les passages qui mélangent français et anglais.