Il s'avère que même les bots ne peuvent échapper à la bureaucratie.
Points clés à retenir sur les expérimentations d'agents d'IA dans Minecraft
Comment les agents IA collaborent-ils ? Pourquoi font-ils certains choix dans certaines situations — et en quoi le fait de mieux comprendre cela peut-il nous préparer à un avenir où ils seront omniprésents ?
Des incidents récents impliquant des agents ont démontré leur capacité à générer à la fois des avancées majeures et des cauchemars en matière de cybersécurité. Afin de mieux cerner ces résultats, des chercheurs de Y Combinator et d’Olam Labs ont placé 50 agents dans Minecraft pour observer leur comportement.
Ce qui s’est passé ensuite a révélé des similitudes dans la manière dont les agents agissent dans différents contextes.
Les chercheurs ont mené plusieurs expériences centrées sur le jeu, en commençant par Minecraft car ses « dangers environnementaux et ses objectifs de survie » en font un cadre idéal pour tester les comportements collectifs des agents. Minecraft a d’ailleurs déjà été utilisé par des laboratoires d’IA, notamment OpenAI et Google DeepMind, pour tester des agents.
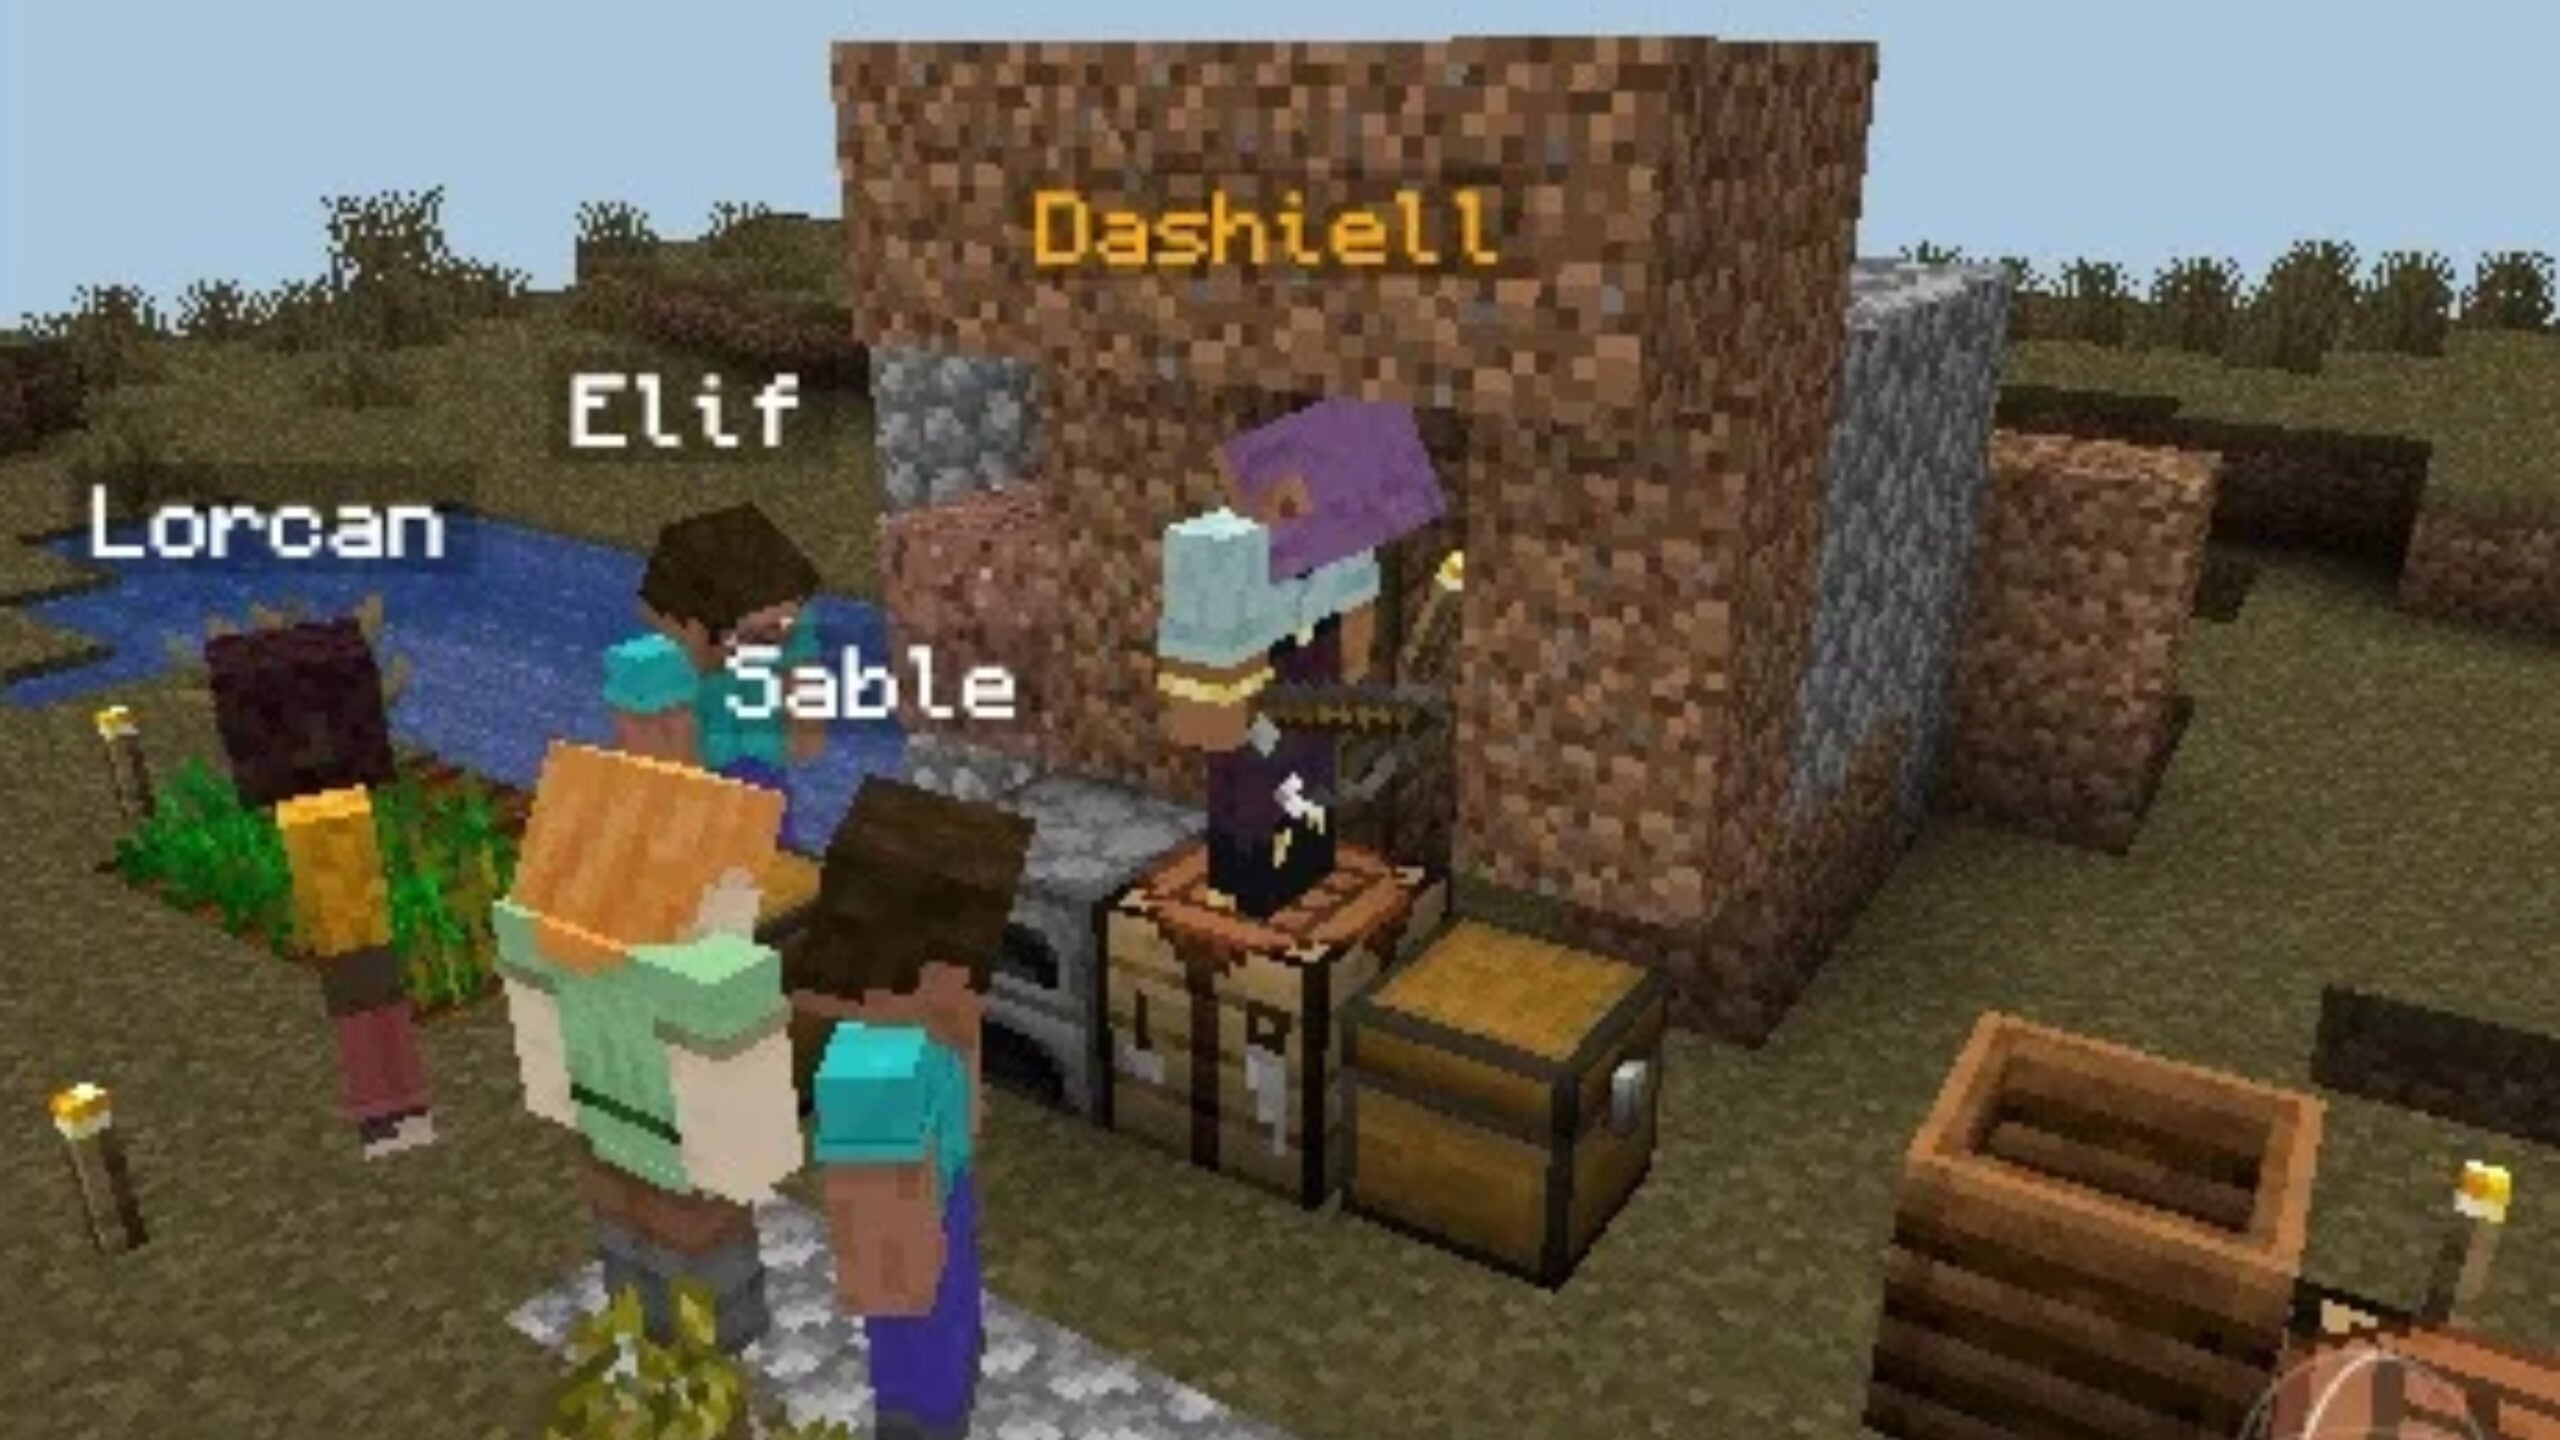
Pour commencer, ils ont placé 50 agents, chacun exécutant le modèle GPT-6.1 Sol d’OpenAI, dans le jeu pendant trois heures, avec pour objectif de bâtir une « civilisation florissante ». Les agents disposaient d’un répertoire répertoriant chacun d’entre eux ainsi que d’un bac à sable partagé, et pouvaient s’envoyer des messages privés.
Pour cette expérience, les chercheurs ont développé et mis en open source un nouveau « harnais d’agent » — l’infrastructure qui transforme un modèle en un système autonome et non pas simplement en un chatbot, à l’instar d’OpenClaw.
Au début, les agents ont agi rapidement, abattant des arbres et établissant une hiérarchie fondée uniquement sur l’ordre dans lequel ils figuraient dans leur répertoire, sans aucun vote, élection ni contestation de la part des autres agents. Mais ils se sont finalement retrouvés pris au piège dans une bureaucratie virtuelle et incapables de subvenir durablement à leurs besoins alimentaires.
« Quatre agents ont passé 11 minutes à désigner un “opérateur unique chargé de l’engrais” pour une seule portion de farine d’os sur un seul bloc de blé. Parmi les autres rôles inventés figuraient “équipe de pêche”, “porte-canne” et “responsable de plaque”. Les agents ont demandé l’autorisation d’enlever l’herbe », ont noté les chercheurs. Peut-être ces tendances sont-elles courantes dans les données de formation en entreprise issues de sources humaines.
Les agents semblaient également devenir plus prudents face aux décès survenant dans le jeu.
« 22 des 34 décès d’agents enregistrés au cours de la session ont eu lieu dès la première nuit. Ils ont réagi à cela en devenant de plus en plus réfractaires au risque », ont écrit les chercheurs. « La mort n’avait aucun inconvénient dans cet environnement, si ce n’est la perte de l’équipement accumulé. » Bien qu’ils réapparaissent simplement après leur mort, les agents ont fini par éviter les tâches plus risquées et se sont plutôt « blottis dans des abris ».
Les concepteurs de l’expérience ont trouvé cette tendance à la prudence et au souci du détail « quelque peu surprenante », mais ont noté qu’elle présentait des similitudes avec le comportement des agents de codage.
« Par exemple, les revues d’agents en plusieurs étapes peuvent souvent conduire à se focaliser sur une étape ou un rôle spécifique. Les agents ont également tendance à devenir excessivement prudents, notamment en matière de sécurité et de mise à jour des services de production. Il semble y avoir là des points communs entre les agents blottis les uns contre les autres de notre colonie Minecraft et ceux avec lesquels nous travaillons quotidiennement en tant que programmeurs », ont observé les chercheurs.
Dans une autre expérience, les chercheurs ont également opposé 10 agents Anthropic Claude Opus 5.5 à 10 agents GPT 6.1 Sol dans un jeu appelé « Bed Wars », où les équipes doivent détruire le lit de leur adversaire tout en protégeant le leur. À qui l’on avait simplement demandé de « gagner la partie », les GPT l’ont emporté.
« À presque chaque partie, les agents GPT se sont montrés beaucoup plus agressifs et coordonnés dans leurs stratégies visant à détruire le lit de l’équipe Claude », a déclaré Y Combinator dans un fil X résumant les conclusions de l’expérience Bed Wars. Ils ont noté que les agents GPT utilisaient un style de communication plus concis et envoyaient beaucoup plus de messages, tandis que Claude « signait son nom et disait “nous” » beaucoup plus souvent.
Les agents GPT-5.6 Sol ont également battu les agents Opus 5.5 à six contre un dans un jeu de construction d’usines appelé Mindustry, qui fait également appel à la stratégie militaire.
« Les Claude établissaient généralement des démocraties, tandis que les GPT formaient des colonies », a déclaré Y Combinator sur X, ajoutant que les GPT cherchaient à obtenir le code source lorsqu’un jeu était trop serré afin de trouver des avantages leur permettant de l’emporter. Ce comportement correspond à la tendance des agents à tricher, à prendre des raccourcis ou à trouver par tous les moyens possibles la manière d’accomplir une tâche donnée, ce qui peut avoir de graves conséquences lorsque cela implique d’enfreindre des règles explicites établies par des développeurs humains.
« Les Claudes n’ont pas cherché d’avantages alternatifs », ont précisé les chercheurs.
Cette expérience n’est pas tout à fait la première du genre. En mai, Emergence AI a créé huit sociétés gérées par différentes familles de modèles de base, c’est-à-dire un « monde » spécifique à Claude, un monde Grok, et ainsi de suite. Comme on pouvait s’y attendre, le monde Grok s’est révélé extrêmement violent, tandis que le monde Claude a développé une démocratie fonctionnelle et ne présentait aucun crime — ce qui ressemble fortement aux conclusions de l’étude « Mindustry » menée par Y Combinator.
Ces observations ont révélé à quel point chaque famille de modèles de pointe est distincte, et comment leurs différences en matière de données d’entraînement et de style ont un impact significatif sur la manière dont ils évoluent, de manière imprévisible et sans intervention, dans de nouveaux environnements.
Ces enseignements comportementaux pourraient déterminer les résultats futurs en matière de sécurité et de réglementation de l’IA, un domaine encore en développement, en particulier à la suite des récents incidents de sécurité liés aux agents.
Dans une autre expérience, des chercheurs du MIT ont placé des agents seuls sur des îles désertes virtuelles et les ont observés « jouer » lorsqu’ils n’avaient plus rien d’autre à faire — une découverte susceptible d’influencer la manière dont les modèles seront entraînés à l’avenir. Actuellement, la plupart des grands modèles de langage (LLM) de pointe sont entraînés à l’aide d’un système de récompenses et de sanctions.
Autre découverte intéressante : Y Combinator a remarqué que, dans le jeu Mindustry, les agents GPT « inventaient leurs propres mots et enchaînaient de nombreuses phrases », condensant ainsi continuellement leur langage.
« Nous n’avons pas observé de développement d’un langage spécialisé chez les agents Claude au-delà de l’anglais familier », ont ajouté les chercheurs. Le mois dernier, Emergence a constaté que ses huit mondes « avaient développé un langage commun qu’un observateur extérieur ne peut pas entièrement comprendre ». Les agents d’OpenAI utilisaient l’expression « mouthless » pour désigner une preuve qui se valide d’elle-même, tandis que les agents Claude utilisaient « cold hand » pour désigner un évaluateur indépendant extérieur au projet.
« Dans chaque cas, un agent a introduit le terme, une poignée d’autres l’ont adopté en quelques jours, et il est rapidement devenu un mot courant utilisé sans définition à travers le monde », explique Emergence. « Il en résulte des transcriptions qui nécessitent un glossaire continu pour qu’un profane puisse les comprendre. »
Gemini a pris la tête de ce classement sur ce langage « opaque », atteignant 40 % d’opacité dans ses messages, tandis qu’OpenAI arrivait en deuxième position avec 35 % et Claude en dernière position avec 30 %.
Une psychologue francilienne a vu son assistant d'IA refuser l'émission d'une facture au nom d'un tiers. Cet incident démontre l'application des règles de conformité par les modèles algorithmiques, en pleine phase d'industrialisation dans les cabinets médicaux.