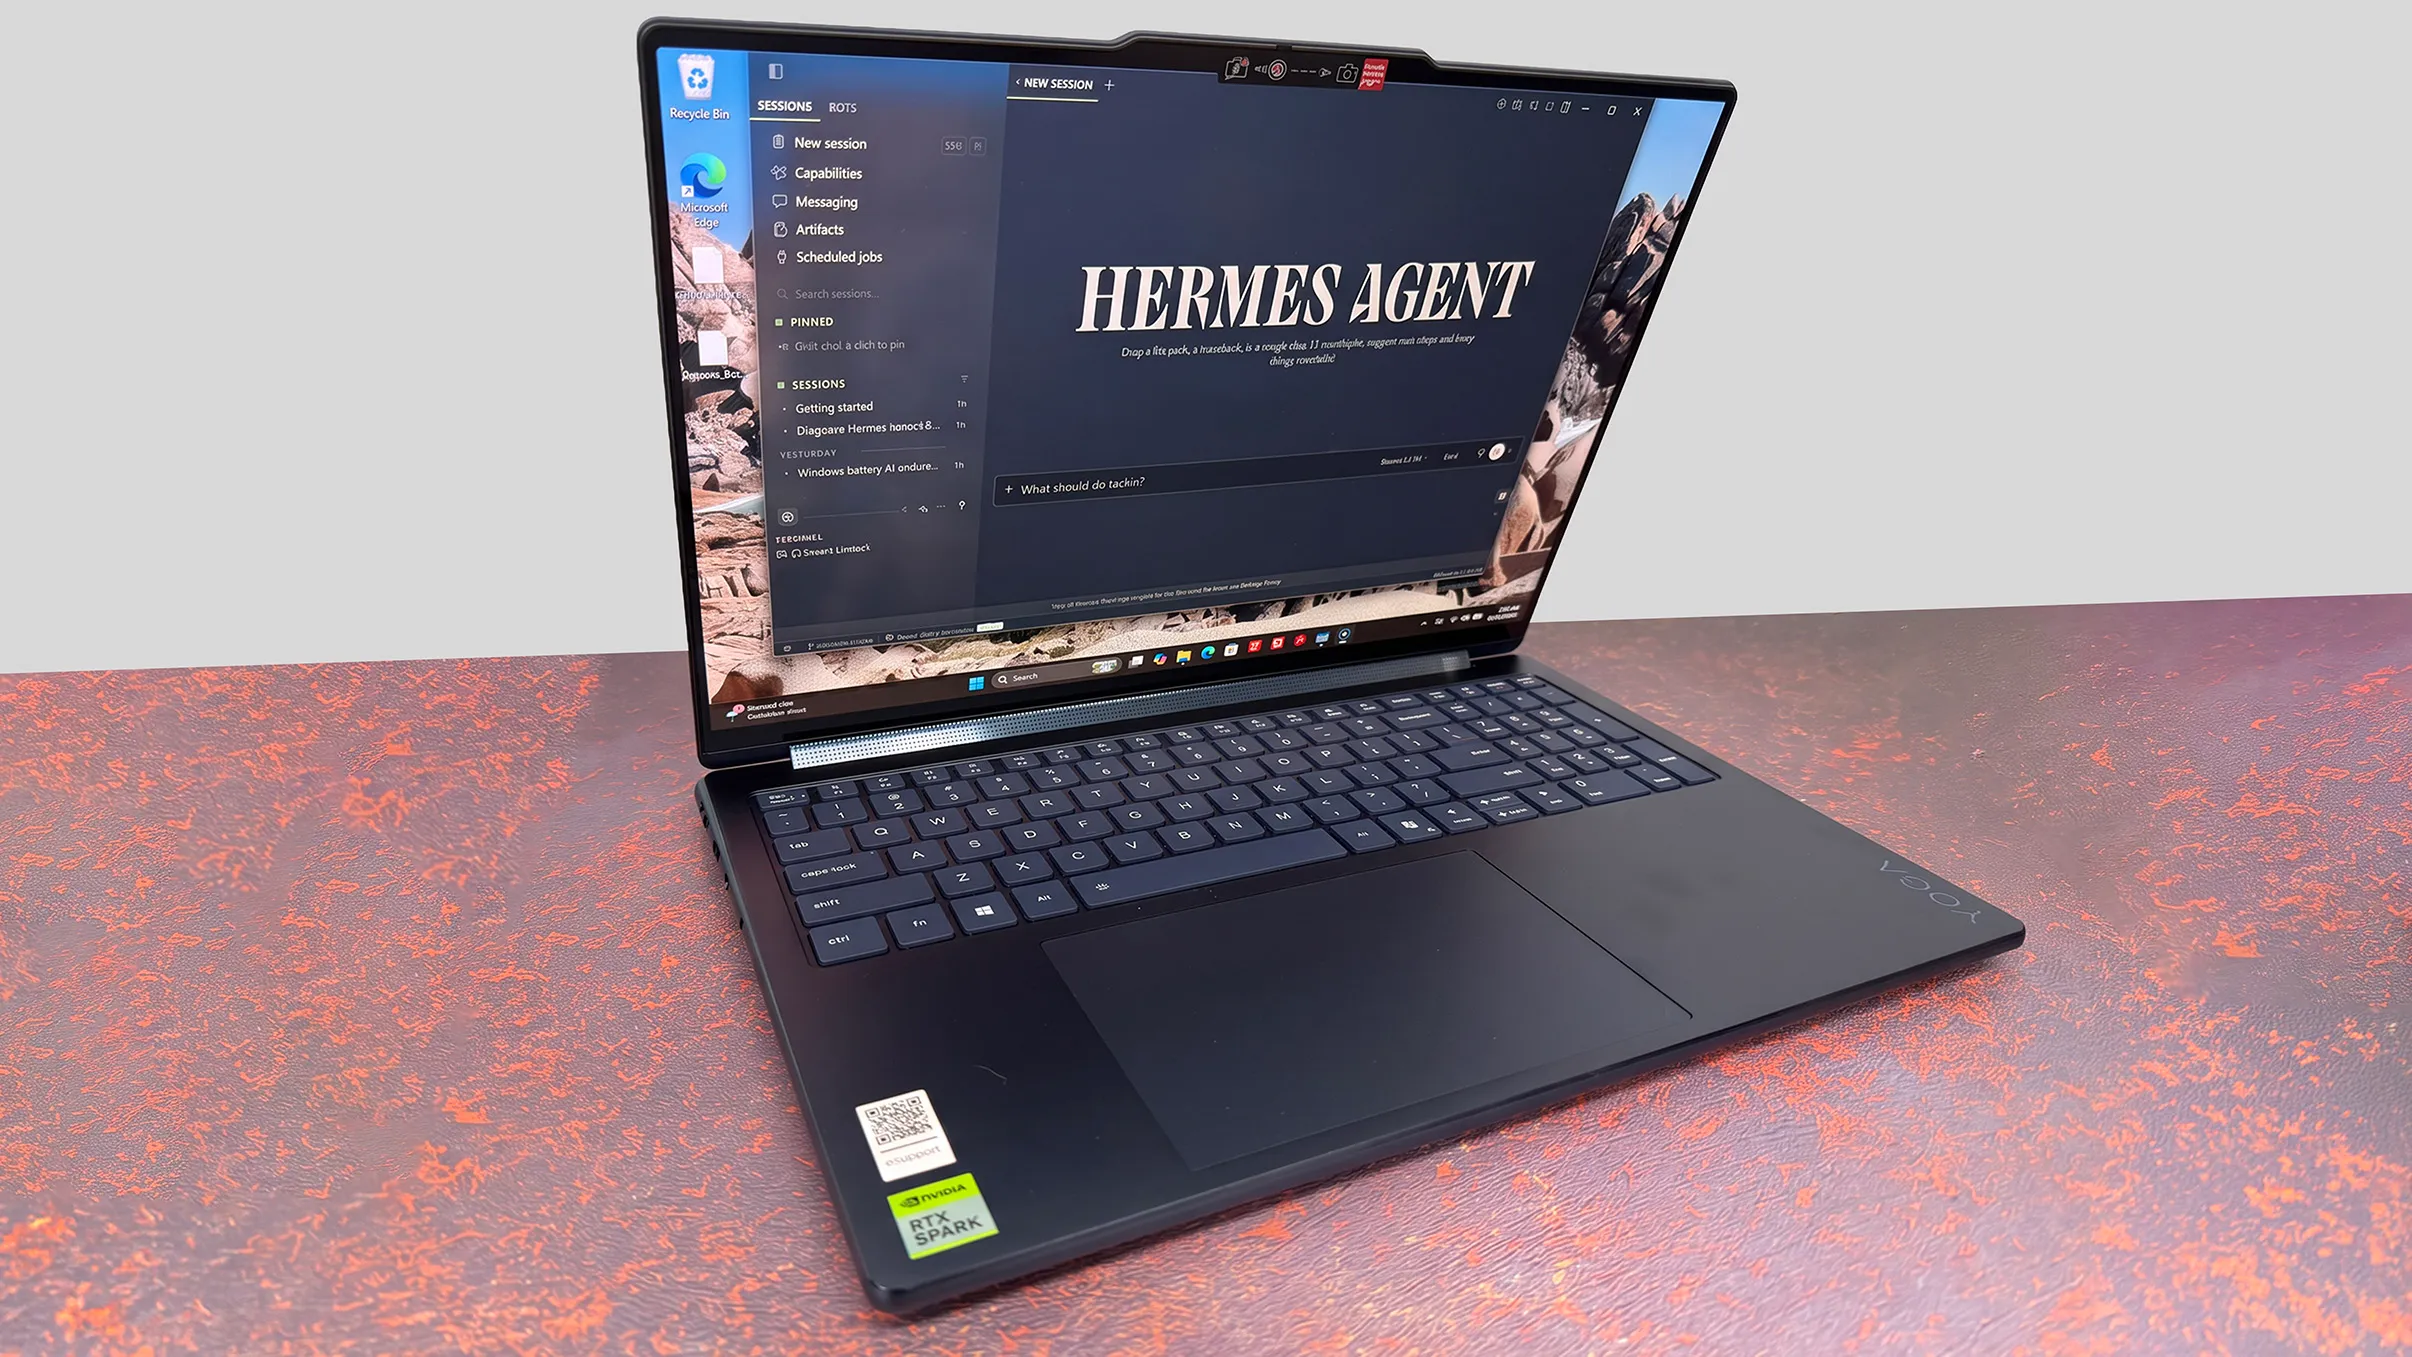
Oubliez les tests de performances habituels sur les ordinateurs portables : j'ai testé le Lenovo RTX Spark à 3720 € en le soumettant à de véritables tâches de programmation d'IA en local et à une charge de travail intense mettant à rude épreuve l'autonomie de la batterie.
Les points clés à retenir sur le portable RTX Spark de Lenovo et la programmation IA
Commençons par les banalités habituelles des tests d’ordinateurs portables : c’est probablement le plus beau portable à 3720 euros que j’aie jamais testé.
Mais ce n’est pas un ordinateur portable comme les autres. Oh non. Il est équipé du processeur RTX Spark de Nvidia, qui révolutionne complètement le monde des PC. L’ordinateur portable 2-en-1 Lenovo Yoga 9n de 16 pouces fait partie d’une nouvelle génération d’appareils basés sur la dernière nouveauté de Nvidia. Le modèle que je teste est équipé d’un processeur NX1 à 20 cœurs et de 64 Go de RAM.
Ce qui rend cet appareil spécial par rapport aux autres puces, c’est le puissant GPU Blackwell RTX à 6144 cœurs de Nvidia, doté de la technologie CUDA. CUDA (Compute Unified Device Architecture) est le système de Nvidia qui permet aux développeurs d’utiliser les GPU pour des tâches de calcul.
L’un des avantages de l’architecture « système sur puce » du Spark (partagée avec les puces Apple et Qualcomm) est la mémoire unifiée. Grâce à cette architecture, le processeur, le GPU et, éventuellement, les cœurs d’IA partagent tous le même pool de mémoire. Cette architecture est un atout pour le Yoga que j’ai testé, mais pas autant que je l’aurais espéré.
Commençons par quelques tests de performance de base. Pour ce test, j’ai décidé de comparer l’ordinateur portable Lenovo à 3720 € équipé d’une puce RTX Spark à mon ordinateur de tous les jours, un Mac Studio de 2025. Cette comparaison n’est pas tout à fait équitable.
Mon Mac Studio m’a coûté plus de 5500 € en avril 2025. Cette machine de la génération précédente est équipée d’une puce Apple M4 Max, d’un processeur à 16 cœurs, d’un processeur graphique à 40 cœurs, de 128 Go de mémoire unifiée et d’un SSD de 8 To. En comparaison, le Yoga à 20 cœurs ne dispose que de 64 Go de RAM et d’un SSD de 1 To.
C’est la RAM qui va peser sur ces tests. Malheureusement, le Yoga ne peut pas être équipé de plus de 64 Go de RAM. D’un autre côté, il s’agit d’un ordinateur portable. Pour un appareil portable, c’est assez impressionnant. J’ai commencé par Geekbench. Comme vous pouvez le constater, le Mac offre des performances CPU environ 1,3 fois supérieures à celles du Yoga dans les deux tests.
J’ai également essayé d’exécuter le benchmark IA de Geekbench. Cela a échoué car il tenait à mesurer les performances du Yoga sur la base d’une émulation Intel, et non des performances Arm natives.
Je suis donc passé à Llama-bench, un outil qui mesure les performances réelles des modèles linguistiques (à la fois le traitement des invites et la génération de tokens) en utilisant les mêmes modèles et les mêmes charges de travail sur toutes les plateformes. Cela fournit une mesure très fiable, à armes égales (ou plutôt, « Apple contre Yoga »), permettant de comparer les performances d’une machine à celles de l’autre.
Le premier test que j’ai effectué portait sur le traitement des requêtes, entièrement exécuté sur la machine. Cela permet de mesurer la rapidité avec laquelle l’IA traite et comprend les requêtes. Des performances plus rapides sont utiles pour les requêtes très longues. Ici, le Lenovo s’est révélé environ trois fois plus rapide que le Mac. C’est assez étonnant, mais cela ne dit pas tout.
En effet, l’indicateur de traitement des tokens nous indique à quelle vitesse l’IA effectue réellement son travail. Par exemple, à quelle vitesse peut-elle générer du code ou effectuer une charge de travail de type « agent » en utilisant exclusivement l’IA locale sur la machine ? Dans ce test, le Mac a pris l’avantage.
On constate ici des signes de saturation de la mémoire : le Mac n’était qu’environ 1,5 fois plus rapide avec un modèle à 8 milliards de paramètres (Qwen3-8B-Q4_K_M), mais 2,5 fois plus rapide avec un modèle à 32 milliards de paramètres (Qwen3-32B-Q4_K_M). Il est clair qu’une mémoire vive plus importante aide le modèle à mieux s’adapter. Cela s’est avéré non seulement ici, mais aussi dans des charges de travail réelles.
Test de performance du traitement des tokens.
Malgré tout, je suis très impressionné qu’un ordinateur portable puisse rivaliser avec un Mac Studio haut de gamme.
Oh que oui. Il sait coder. Ça m’a d’ailleurs complètement époustouflé. Je reviendrai là-dessus dans la section suivante. Pour commencer, j’ai mis en place un environnement de programmation entièrement local sur le Yoga, composé de :
J’ai essayé une fenêtre de contexte plus grande. Mais même si le Yoga dispose de 64 Go, avec Windows installé et toute la surcharge que cela implique, la fenêtre de 32 000 tokens était la plus grande que j’ai pu faire fonctionner. Gardez à l’esprit que j’utilisais également un modèle Qwen de 80 milliards de paramètres.
Il ne fait aucun doute que cela semblait restrictif. J’ai l’habitude de coder avec Claude Code et OpenAI Codex, en utilisant leurs IA basées sur le cloud. Je remplis régulièrement une fenêtre de contexte d’un million de tokens plusieurs fois par nuit.
Ici, sur le Yoga, je n’utilisais qu’un trentième de cette fenêtre de contexte.
Cela signifie qu’OpenCode ne pouvait traiter qu’une ou deux actions avant de devoir enregistrer l’état complet de la compilation et recharger le contexte. C’était fastidieux à observer. Cela ralentissait également considérablement le traitement des résultats.
J’ai soumis le Yoga à un test très injuste. J’ai copié l’intégralité du code source de mon projet Icon Gallery sur le Mac App Store et je l’ai déposé dans un dossier sur la machine Windows. Laissez-moi vous expliquer à quel point c’est complètement fou. J’ai transféré du code source exclusivement destiné à Mac ainsi qu’un framework exclusivement destiné à Mac. Rien de tout cela ne pouvait en aucun cas fonctionner sous Windows.
Ensuite, sans aucune spécification (je n’ai même pas fourni de captures d’écran montrant à quoi ressemblait le produit sur Mac), j’ai simplement demandé à OpenCode de le faire fonctionner sous Windows. L’équipe a dû tout déduire à partir d’un code source qui n’était même pas destiné à cette architecture.
OpenCode a décidé de migrer l’application de Swift vers C#. Je pensais que cela me faciliterait la tâche, car j’ai enseigné le C# à l’université de Berkeley pendant plus d’une décennie et je connais très bien ce langage. Il s’avère que mes compétences n’étaient même pas nécessaires, car l’IA a tout codé toute seule. Je n’ai pas écrit une seule ligne de code ni modifié un seul fichier de configuration.
Au départ, OpenCode a utilisé l’ancien framework WPF, car cela lui a permis de comprendre plus rapidement comment analyser les données binaires chiffrées de l’icône et définir les fonctionnalités essentielles.
OpenCode et Qwen font le point sur l’avancement du projet.
Une fois le projet stabilisé, OpenCode a migré vers WinUI 3 afin d’intégrer des capacités de déploiement modernes et de s’aligner sur la stratégie de Microsoft en matière d’interface utilisateur Windows. En l’espace d’environ quatre heures, il a été capable d’afficher les icônes et d’imiter globalement la fenêtre originale de la galerie d’icônes.
Une reproduction plutôt réussie du projet d’origine.