Recevez tous les soirs un résumé de l’actu importante avec Le Récap’
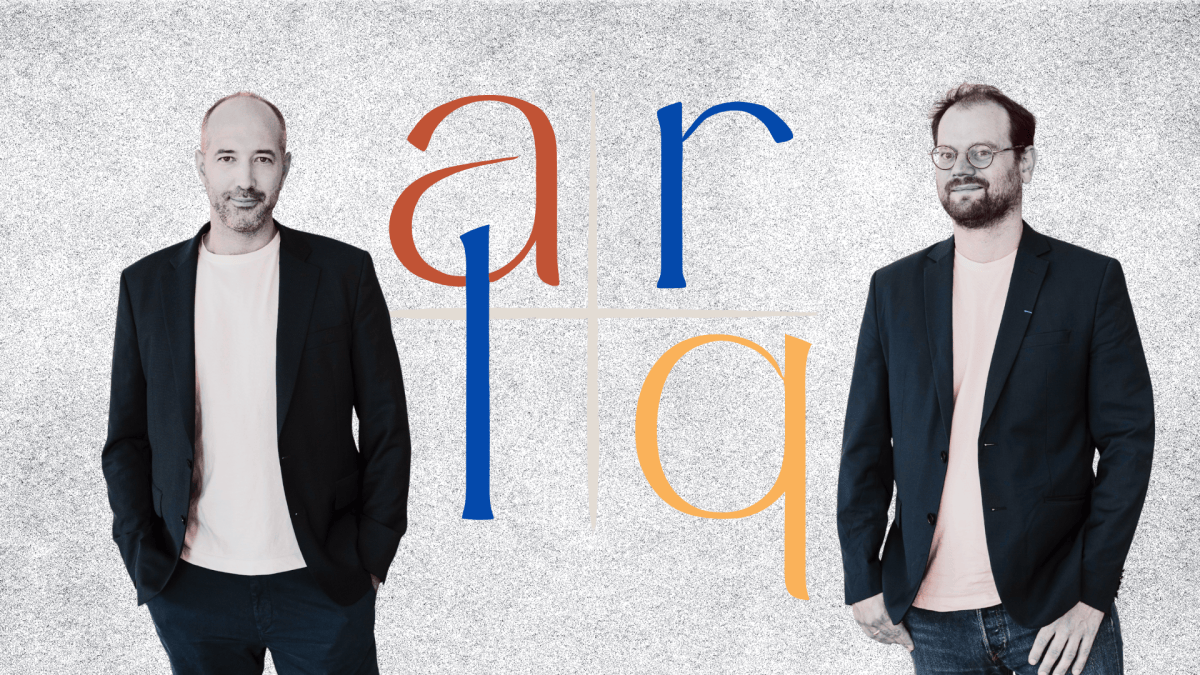
C’est un changement d’échelle, et le point de départ de cette rencontre. Le 10 septembre, Arlequin AI annonçait une levée de fonds de 28 millions d’euros en série A.
L’occasion d’échanger avec les fondateurs de cette start-up française de la deeptech, qui voient dans l’intérêt des investisseurs la confirmation du potentiel des réseaux de neurones topologiques développés par l’entreprise. Selon eux, ces technologies se trouvent aujourd’hui « à peu près au même niveau de développement que les LLM il y a dix ans ».
Déjà déployée en France, au Royaume-Uni et en Allemagne, dans le secteur public comme dans le privé, l’entreprise compte sur cette levée pour passer à la vitesse supérieure. Avec, en ligne de mire, l’ouverture d’un laboratoire à San Francisco, consacré notamment à la sécurité des systèmes d’IA les plus avancés.
Aux commandes, deux profils bien distincts. Hugo Micheron vient des sciences politiques, tandis qu’Antoine Jardin est chercheur au CNRS en data science, spécialisé dès ses débuts dans la réduction de dimensionnalité, un domaine mathématique qui s’avérera central dans l’architecture d’Arlequin AI.
Le nom de l’entreprise porte d’ailleurs la trace de ces deux univers. Arlequin, figure carnavalesque de la Commedia dell’arte, évoque ces moments où le vrai et le faux s’inversent, à l’image d’un monde informationnel dans lequel l’entreprise veut « voir clair à travers le désordre », explique Hugo Micheron. Pour les initiés, c’est aussi un clin d’œil mathématique, puisque les losanges du costume évoquent le complexe simplicial, la structure au cœur des réseaux de neurones topologiques. Nous y reviendrons.
Les deux hommes se connaissent depuis quinze ans, et leur histoire commune a quelque chose d’un jeu de miroir. « C’est presque Antoine qui m’a décidé à faire une thèse il y a quinze ans », raconte Hugo Micheron. « Ce qui l’amène parfois à dire que c’est moi qui l’ai décidé à monter une start-up il y a deux ans. »
De cette amitié de longue date est née une conviction partagée. « Historiquement, les problèmes relatifs au comportement humain, on ne les traite pas avec des modèles mathématiques très avancés », résume Hugo Micheron. C’est précisément cette lacune que l’essor des réseaux de neurones vient combler, à condition, disent-ils, de ne pas se tromper d’outil.
Avant de décrire ce que fait Arlequin AI, il faut préciser ce que l’entreprise n’est pas. Depuis l’explosion de ChatGPT, le terme « intelligence artificielle » est souvent réduit, à tort, à une seule famille de technologies : les grands modèles de langage (LLM), génératifs par construction. Arlequin AI ne s’inscrit pas dans cette famille, et ses fondateurs voient d’ailleurs dans cette confusion un malentendu qui dessert la compréhension du secteur tout entier.
« Les LLM ont fait écran à l’étendue du champ de l’IA », résume Hugo Micheron. Hugo Micheron ne rejette pas pour autant les modèles de langage (Arlequin peut amener à les utiliser, comme on le verra), il rappelle leur nature : « Les LLM sont des modèles de génération et de raisonnement très intéressants. Mais ils n’ont jamais été conçus pour être des modèles d’analyse systématique sans inférer de biais. »
Autrement dit, un LLM produit des sorties à partir d’une modélisation probabiliste. Un fonctionnement qui peut devenir une limite lorsqu’il s’agit de garantir, sans mécanisme de vérification supplémentaire, un résultat exact et reproductible.
Or, dans les secteurs où opère Arlequin, notamment la sécurité, la défense et la finance, le besoin de fiabilité est essentiel : « Si on rate une information, ça peut avoir des conséquences dramatiques. […] Dans ces secteurs-là, les applications des LLM sont limitées », insiste Hugo Micheron. C’est ce constat, partagé selon lui par l’ensemble des acteurs du marché, qui a poussé Arlequin à explorer une tout autre architecture dès sa création : les réseaux de neurones topologiques.
Pour saisir ce que change cette architecture, il faut revenir sur la manière dont les systèmes d’IA actuels représentent l’information.
Aujourd’hui, les modèles les plus connus, les Transformers, qui propulsent les LLM, excellent à mettre en relation chaque élément d’un texte ou d’un jeu de données avec tous les autres. Lorsqu’il s’agit de modéliser des structures physiques ou des réseaux complexes, l’industrie s’appuie souvent sur des réseaux de neurones graphiques (GNN), qui représentent le monde sous forme de points reliés deux à deux par des lignes.
Si ces approches sont puissantes, elles présentent toutes deux des limites pour modéliser finement des interactions de groupe complexes. Les Transformers lient les éléments par des associations statistiques globales, parfois floues, tandis que les GNN représentent principalement les relations deux à deux. En clair, ces architectures classiques ne représentent pas toujours explicitement ce qui émerge quand trois, quatre ou dix éléments s’associent simultanément.
C’est exactement ce que cherchent à corriger les réseaux de neurones topologiques (TNN) sur lesquels travaille Arlequin AI. Plutôt que de se limiter à des relations deux à deux, ils s’appuient sur des structures mathématiques issues de la topologie. Non plus seulement « A est lié à B », mais « A, B et C forment ensemble un bloc cohérent ». On passe donc de simples lignes entre deux points à de véritables « formes » (des triangles ou des tétraèdres pleins) qui englobent plusieurs éléments à la fois.
Ce champ de recherche, encore jeune, baptisé le « topological deep learning », est notamment étudié pour analyser des réseaux biologiques, l’activité du cerveau ou des systèmes financiers très complexes.
Antoine Jardin, qui porte la dimension technique du projet, résume l’objectif : « Dans les systèmes de traitement de données complexes, on a besoin de certifier les relations et de regarder de très près la façon dont beaucoup de points de données sont connectés entre eux. (…) C’est un peu comme le travail de journaliste : on prend plein d’éléments d’information, et il faut les relier entre eux d’une façon qui soit vérifiable et auditable. »
À quoi ressemble l’usage d’Arlequin pour un client ? « On prend n’importe quel jeu de données, vidéo, audio, texte, image, peu importe. On le met dans la plateforme Arlequin, pas de prompt, pas de message, rien et on obtient une visibilité totale de notre jeu de données », décrit Hugo Micheron.
À partir de là, des modèles non supervisés analysent l’intégralité de l’information, en extraient les relations, les signaux et les structures pertinentes, et stockent ce résultat « à froid », c’est-à-dire déjà calculé, prêt à être interrogé.
Et ce n’est qu’à ce stade qu’un LLM peut entrer en jeu, non pour produire une réponse, mais pour aller chercher, dans cette base déjà constituée, l’information pertinente et la restituer à l’utilisateur. « Les LLM sont très utiles pour permettre d’accéder en langage naturel aux résultats qui sont calculés de façon complètement indépendante par nos systèmes. Nous n’utilisons jamais les LLM pour produire ni modifier les résultats eux mêmes. C’est ce qui leur permet d’etre audités et vérifiés de façon exhaustive. », détaille Antoine Jardin.
Voilà donc pourquoi le cœur d’Arlequin n’est pas génératif : son rôle se joue en amont, dans l’analyse et la structuration des informations contenues dans les données.
L’intérêt de cette approche, selon les fondateurs, est de révéler des phénomènes invisibles aux outils d’analyse classiques. Antoine Jardin cite l’exemple du risque financier : « il peut y avoir toute une série de transactions entre des individus, deux par deux, qui sont légales, mais le système d’ensemble, la structure globale, témoigne d’une activité illégale. »
Autre argument, celui du biais. Sans couche générative pour interpréter la donnée, Arlequin élimine-t-elle mécaniquement le biais ? « Ça va dépendre de la donnée que l’on met en entrée », précise Hugo Micheron, « si on injecte des données biaisées, naturellement le résultat le sera aussi, la plateforme analyse ce qu’on lui transmet, sans rien y ajouter. »
En revanche, l’outil se distingue par sa capacité à corriger le biais de confirmation de l’utilisateur lui-même. Lorsqu’un analyste ne consulte qu’une fraction de ses données pour étayer une hypothèse préexistante, la plateforme peut le signaler. « Il pourra dire : attention, on est en train de regarder 0,1 % de la donnée, et on est en train de tirer des conclusions sur quelque chose qui est en fait le petit bout de la lorgnette », explique Hugo Micheron, avant d’opposer ce comportement à celui de l’IA générative, « nos modèles vont refléter ce que révèle la donnée, sans y rajouter d’éléments externes ou hypothèses utilisateurs ».
Les cas d’usage se répartissent, sans grande surprise, autour de la sécurité et de la défense, mais aussi autour de ce que les fondateurs appellent « l’usage stratégique de l’information » : fraude bancaire, désinformation, cyberattaques (dont les journaux de logs constituent, par nature, des données de connectivité particulièrement adaptées à ce type d’analyse). D’autres exemples sortent de ce périmètre attendu, comme les clubs de football qui doivent analyser « toutes les stats de trois saisons de joueurs sur l’intégralité des sept grands championnats », décrit Hugo Micheron. Un volume de données considérable, dans lequel il s’agit d’extraire les éléments les plus saillants, ou au contraire de révéler des configurations que personne n’avait anticipées.
Arlequin AI se positionne également dans l’analyse massive d’information pour des médias ou des services d’enquête.
La traçabilité est peut-être l’argument le plus structurant de l’entretien. Avec un LLM, rappelle Antoine Jardin, « on ne peut pas tracer le comportement des LLM. On ne peut pas observer ce qui se passe à l’intérieur, on ne peut pas vérifier. »